零基础AI入门-01 | Java后端转AI,「咖啡师不种豆」核心理念
最近很多 Java 后端同学来找我,状态高度一致:
想转 AI、想做 Agent,但不知道从哪下手,越学越焦虑。
打开教程,要么让你从零训练大模型、要么让你啃海量论文、要么一上来就是万亿参数、多卡训练、微调炼丹。
看着看着就会产生一种错觉:好像不训模型、不搞底层,就不算真正学 AI。
作为从 Java 后端一路走到 AI 应用开发的开发者,我想说一句实话:这是绝大多数后端转 AI 的人,踩的第一个、也是最大的误区。
普通开发者、后端工程师,根本不需要从「种豆子」开始。
读完这篇文章,你会得到三样东西:
- 一个判断:哪些是模型厂商的活,哪些才是你的活
- 一个信心:为什么 Java 后端在 AI 时代不是劣势,而是优势
- 一张地图:这个系列 7 篇的完整学习路线
01 为什么说:我们不要去「种豆」
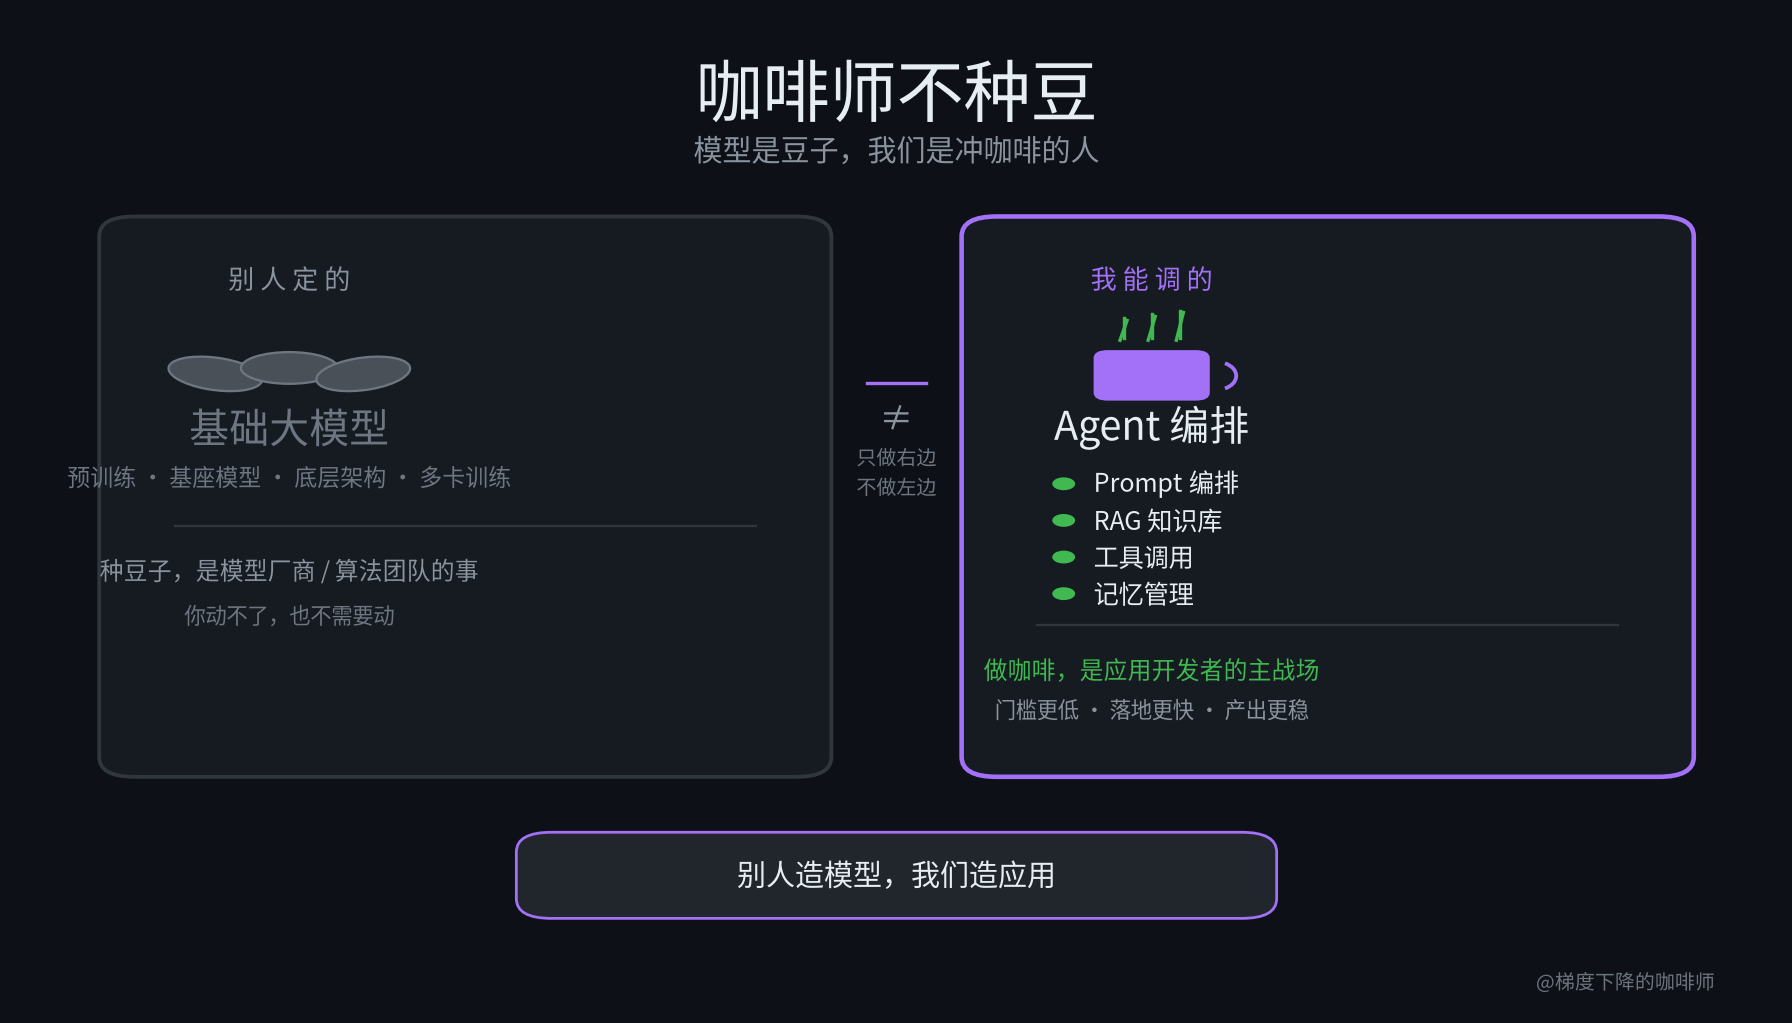
大模型,就是豆子。
预训练、基座模型研发、底层架构、多卡训练、数据清洗——这些是模型厂商、算法团队、科研团队的工作。
就像咖啡店不需要自己种地、育种、烘豆子。
咖啡店要做的是:选好豆子、把控流程、搭配组合、调出好喝的咖啡。
我们开发者,就是 AI 时代的咖啡师。
我们的主战场从来不是「从零造模型」,而是:
- ✅ 调用大模型能力
- ✅ 写 Agent 智能体逻辑
- ✅ 做工具调用、任务编排
- ✅ 搭 RAG 知识库、做记忆管理
- ✅ 做微调落地、数据工程、效果评估
- ✅ 把 AI 能力装进业务系统、Java 服务、生产链路
别人造模型,我们造应用。
这是一条门槛更低、落地更快、产出更稳、更适合后端工程师的路线。
谁需要「种豆」?一张表看清分工
| 角色 | 干的事 | 需要的资源 |
|---|---|---|
| 模型厂商 / 科研团队 | 预训练、基座模型、对齐(RLHF/DPO)、多卡训练 | 海量数据、算力集群、研究团队 |
| 应用开发者(你) | 调用模型、编排 Agent、RAG、工具、落地生产 | 一台能跑代码的电脑 + API key |
| 微调工程师(进阶) | LoRA / SFT / DPO、数据构造、效果评估 | 单卡 GPU(可选,非必须) |
结论:99% 的应用场景,你在「应用层」就能做出很有价值的东西;种豆子是少数人的活。
02 为什么 Java 后端特别适合做 AI 应用?
很多人觉得:AI 是 Python 的天下,Java 过时了、不适合。
这是完全错误的认知。
模型推理、训练确实吃 Python;但 AI 落地、线上服务、工程稳定,极度吃后端能力。
你多年积累的 Java 能力,全部能用:
复杂业务梳理、状态管理、异步队列、并发、权限、缓存、数据库、服务解耦、线上稳定性、日志监控、故障排查……
而现在绝大多数 AI 教程,极度缺工程思维。
网上的 Agent 教程:能跑 Demo、能聊天、能演示,但一上线全是问题:
没有会话隔离、没有持久化、没有权限控制、没有异常兜底、没有记忆裁剪、并发乱串、上下文爆炸、越跑越慢……
这恰恰是 Java 后端的优势区,也是我们的机会区。
能力对照表:线上 Agent 的坑 vs 你已有的经验
| 线上 Agent 的典型坑 | Java 后端已有经验 |
|---|---|
| 会话隔离(多用户串号) | Session / 多租户设计 |
| 状态持久化(重启全丢) | 数据库、缓存、事务 |
| 工具权限(危险操作) | 鉴权、RBAC、接口权限 |
| 并发与限流(上下文爆炸) | 线程池、限流、熔断降级 |
| 异常兜底(工具调用失败) | 异常体系、重试、降级 |
| 可观测性(出了事查不到) | 日志、监控、Trace 链路 |
所以,你的路线不是「从 Java 逃跑」,而是带着 Java 的工程思维走进 Agent 的世界。
03 本系列的定位:不玄学、不焦虑、全部可复现
市面上太多 AI 教程只有两个极端:
- 纯理论堆概念,听完不会写代码
- 堆砌 API,只会复制粘贴,出问题完全不会排错
这个《零基础 AI 入门》系列,我专门为 Java 转 AI 应用开发者 写。
适合谁:从 Java 等工程语言转向 AI 应用开发的开发者,有一点编程经验,想快速做出能上线的 AI 应用。
不适合谁:想从零研究大模型原理、做基座模型的人——那请直接去看论文和经典教材,这个系列帮不了你。
我的写作原则非常简单:
- ✅ 不讲空话、不贩卖焦虑
- ✅ 从工程视角切入,不堆论文、不堆公式
- ✅ 先手写、再框架,先懂原理、再提效率
- ✅ 每一篇都带实战、带踩坑、带可运行代码
- ✅ 所有内容聚焦:能落地、能上线、能复用
04 系列整体学习路线(提前剧透)
整个入门系列会遵循一条非常清晰的进阶路径:
破除思维坑 → 手写最简 Agent → 解决记忆问题 → 补齐生产能力 → 平滑过渡 LangGraph
具体篇目节奏:
| 篇目 | 主题 | 核心产出 |
|---|---|---|
| 第 1 篇(本文) | 咖啡师不种豆:核心理念 | 破除「必须训模型」的误区 |
| 第 2 篇 | Java 转 Python 必踩 6 个坑 | 改掉旧思维,少走弯路 |
| 第 3 篇 | 手写第一个 ReAct Agent | 彻底读懂 Function Calling |
| 第 4 篇 | Agent 记忆:滑窗剪枝、摘要压缩 | 解决越聊越长、越聊越笨 |
| 第 5 篇 | 手写 Agent 生产体检 | 持久化、多用户隔离、工具权限 |
| 第 6 篇 | LangGraph 重构手写 Agent | 理解状态、节点、边 |
| 第 7 篇 | 人工审批 + 持久化落地 | 入门收官,可上线雏形 |
全程:先痛苦手写踩坑,再优雅上框架。
这也是我认为最高效的 AI 工程学习方式——你手写过一遍,再去看框架,每一行都能对上号,而不是照着 API 抄。
05 常见疑问 FAQ
Q1:不学底层、不研究论文,会不会被淘汰?
不会。应用层每年都在变,但「模型能力 + 工程落地」是长期不变的需求。底层研究是少数人的工作,应用层是绝大多数工程师的战场。把 Agent、RAG、工具调用打磨扎实,价值不亚于训一个模型。
Q2:要不要先系统学 Python 再入门?
不用。用 Java 思维直接上手写 AI 代码,踩几个坑就熟了——下一篇专门讲 Java 转 Python 必踩的 6 个坑,比从头啃语法书快得多。
Q3:没有 GPU 能做 AI 应用吗?
能。应用开发全部走 API 调用,不需要本地 GPU;微调(LoRA 等)才需要单卡 GPU,那是进阶话题。入门阶段一台普通电脑 + 一个 API key 就够。
Q4:微调算不算「种豆」?
微调是「调豆」,不是「种豆」——你不动基座模型,只是在你自己的数据上让模型更懂你的业务。它属于进阶能力,本系列后面《微调把脉》栏目会专门讲。
06 配套资源
- 本系列专栏:本站「零基础 AI 入门」栏目(gradcoffee.com/ai-basics/),每篇完整教程 + 可运行代码
- GitHub:github.com/gradcoffee,每篇配套可运行仓库,文章里的代码都能跑
- ForJSON:forjson.com,作者自制的在线 JSON 工具(27 个工具)。Function Calling、结构化输出、RAG 元数据调试时格式化 JSON 很顺手
- 公众号:梯度下降的咖啡师,发布精简版 + 更新提醒
写在最后
很多 Java 后端同学准备切入 AI 开发的时候,第一反应就是想着先要去啃模型底层、研究预训练,甚至直接计划上手训练大模型。
并不是说底层研究没有价值,但普通应用开发者直接扎进这块,很容易耗费大量时间却难以落地产出。
希望读完本系列之后,大家可以建立这样一种认知:我们不必非要去「种豆子」;先做好咖啡师,专注上层的编排与工程落地,把 Agent、RAG、工具调用这些能力打磨扎实,同样可以做出很有价值的 AI 应用。
后面的文章,我们就从迁移层面的坑点开始,逐步手写 Agent,再过渡到 LangGraph 框架。
关于作者
梯度下降的咖啡师,后端工程师出身。先后从事 Java 后端与 AI 应用开发。聚焦 Java 开发者视角下的 LLM 应用、Agent 工程、RAG、LoRA 微调实战;拒绝贩卖焦虑,坚持示例代码可复现。
🔔 下一篇预告
《零基础AI入门-02》:Java 转 Python 踩 6 个坑
聊一聊 Java 工程师刚上手写 Python AI 代码时,非常容易踩进去的思维惯性陷阱,为后续手写 Agent 做好准备。
本文来自「梯度下降的咖啡师」《零基础 AI 入门》系列第 1 篇。