图:深烘咖啡配终端——Java 旧炉,Python 新火
《零基础 AI 入门》第 2 篇|作者:梯度下降的咖啡师 | 8 年 Java 后端(京东、字节)+ 2 年 AI 应用开发
刚从 Java 转到 Python 写 AI 那阵,我干过一件现在想起来挺好笑的事:调 OpenAI SDK,按十年后端的肌肉记忆先认认真真写了个 ChatCompletionDTO,字段配好、类型标好,准备强类型接住返回值。结果一跑——人家给我返回了个 dict,key 还得自己对着文档猜。
那一刻我意识到:从 Java 转到 Python 写 AI 代码,要踩的坑根本不是语法,是十年攒下来的那套工程肌肉记忆。
这篇把我踩过的 6 个坑一次讲清,最后附一段改个 key 就能跑的 Function Calling 代码。
网上讲 Java 转 AI 的文章不少,但大多在聊要不要转、面试怎么面、职业怎么规划。这篇不聊那些,只讲动手写代码头两周具体摔的跟头——都是写 OpenAI SDK、起 Agent 原型时真踩过的。
01 先对齐认知:大模型就是个字符串函数
花两分钟把本质讲清楚,不然下面六个坑你会觉得我在矫情。
你把大模型想象成一个函数:输入一段字符串,输出一段字符串。就这么简单。没有 ORM,没有序列化,没有 Spring 容器。你给它 prompt,它回你 text。
那 Function Calling 是什么?就是模型在生成输出时,不直接给你文字,而是说一句:“我觉得你应该调这个函数,参数是这些。“它不会真的去调——调不调、怎么调、调完把结果塞回对话,全是你代码里干的事。
用 Java 后端的话讲:模型是个不持有状态的字符串处理器,Function Calling 是它抛给你的一个"待办 RPC 请求”。你拿到这个请求,自己 dispatch 到本地方法,把结果填回去,再让它接着说。理解了这一层,下面六个坑就都顺了。
02 开始前你需要
在踩坑之前,确认你手上这几样东西准备好了:
- Python 3.10+ 已安装(去 python.org 下就行)
- 一个 OpenAI API Key(放到环境变量 OPENAI_API_KEY 里)
- 终端里跑一句 pip install openai
- 基础 Java 后端经验(有 Spring Boot 经验更佳,没有也没关系)
搞定这些,咱们开始。
本系列统一用 DeepSeek——国内直接访问,不用搞中转。去 platform.deepseek.com 注册充值就能拿 API Key,base_url 填 https://api.deepseek.com,模型名用 deepseek-v4-flash。它兼容 OpenAI SDK 的调用方式,其他代码一模一样。后面的文章都用这个配置,你想换通义千问、智谱 GLM 也行,改 base_url 和模型名就够。
03 六个坑,逐个踩过
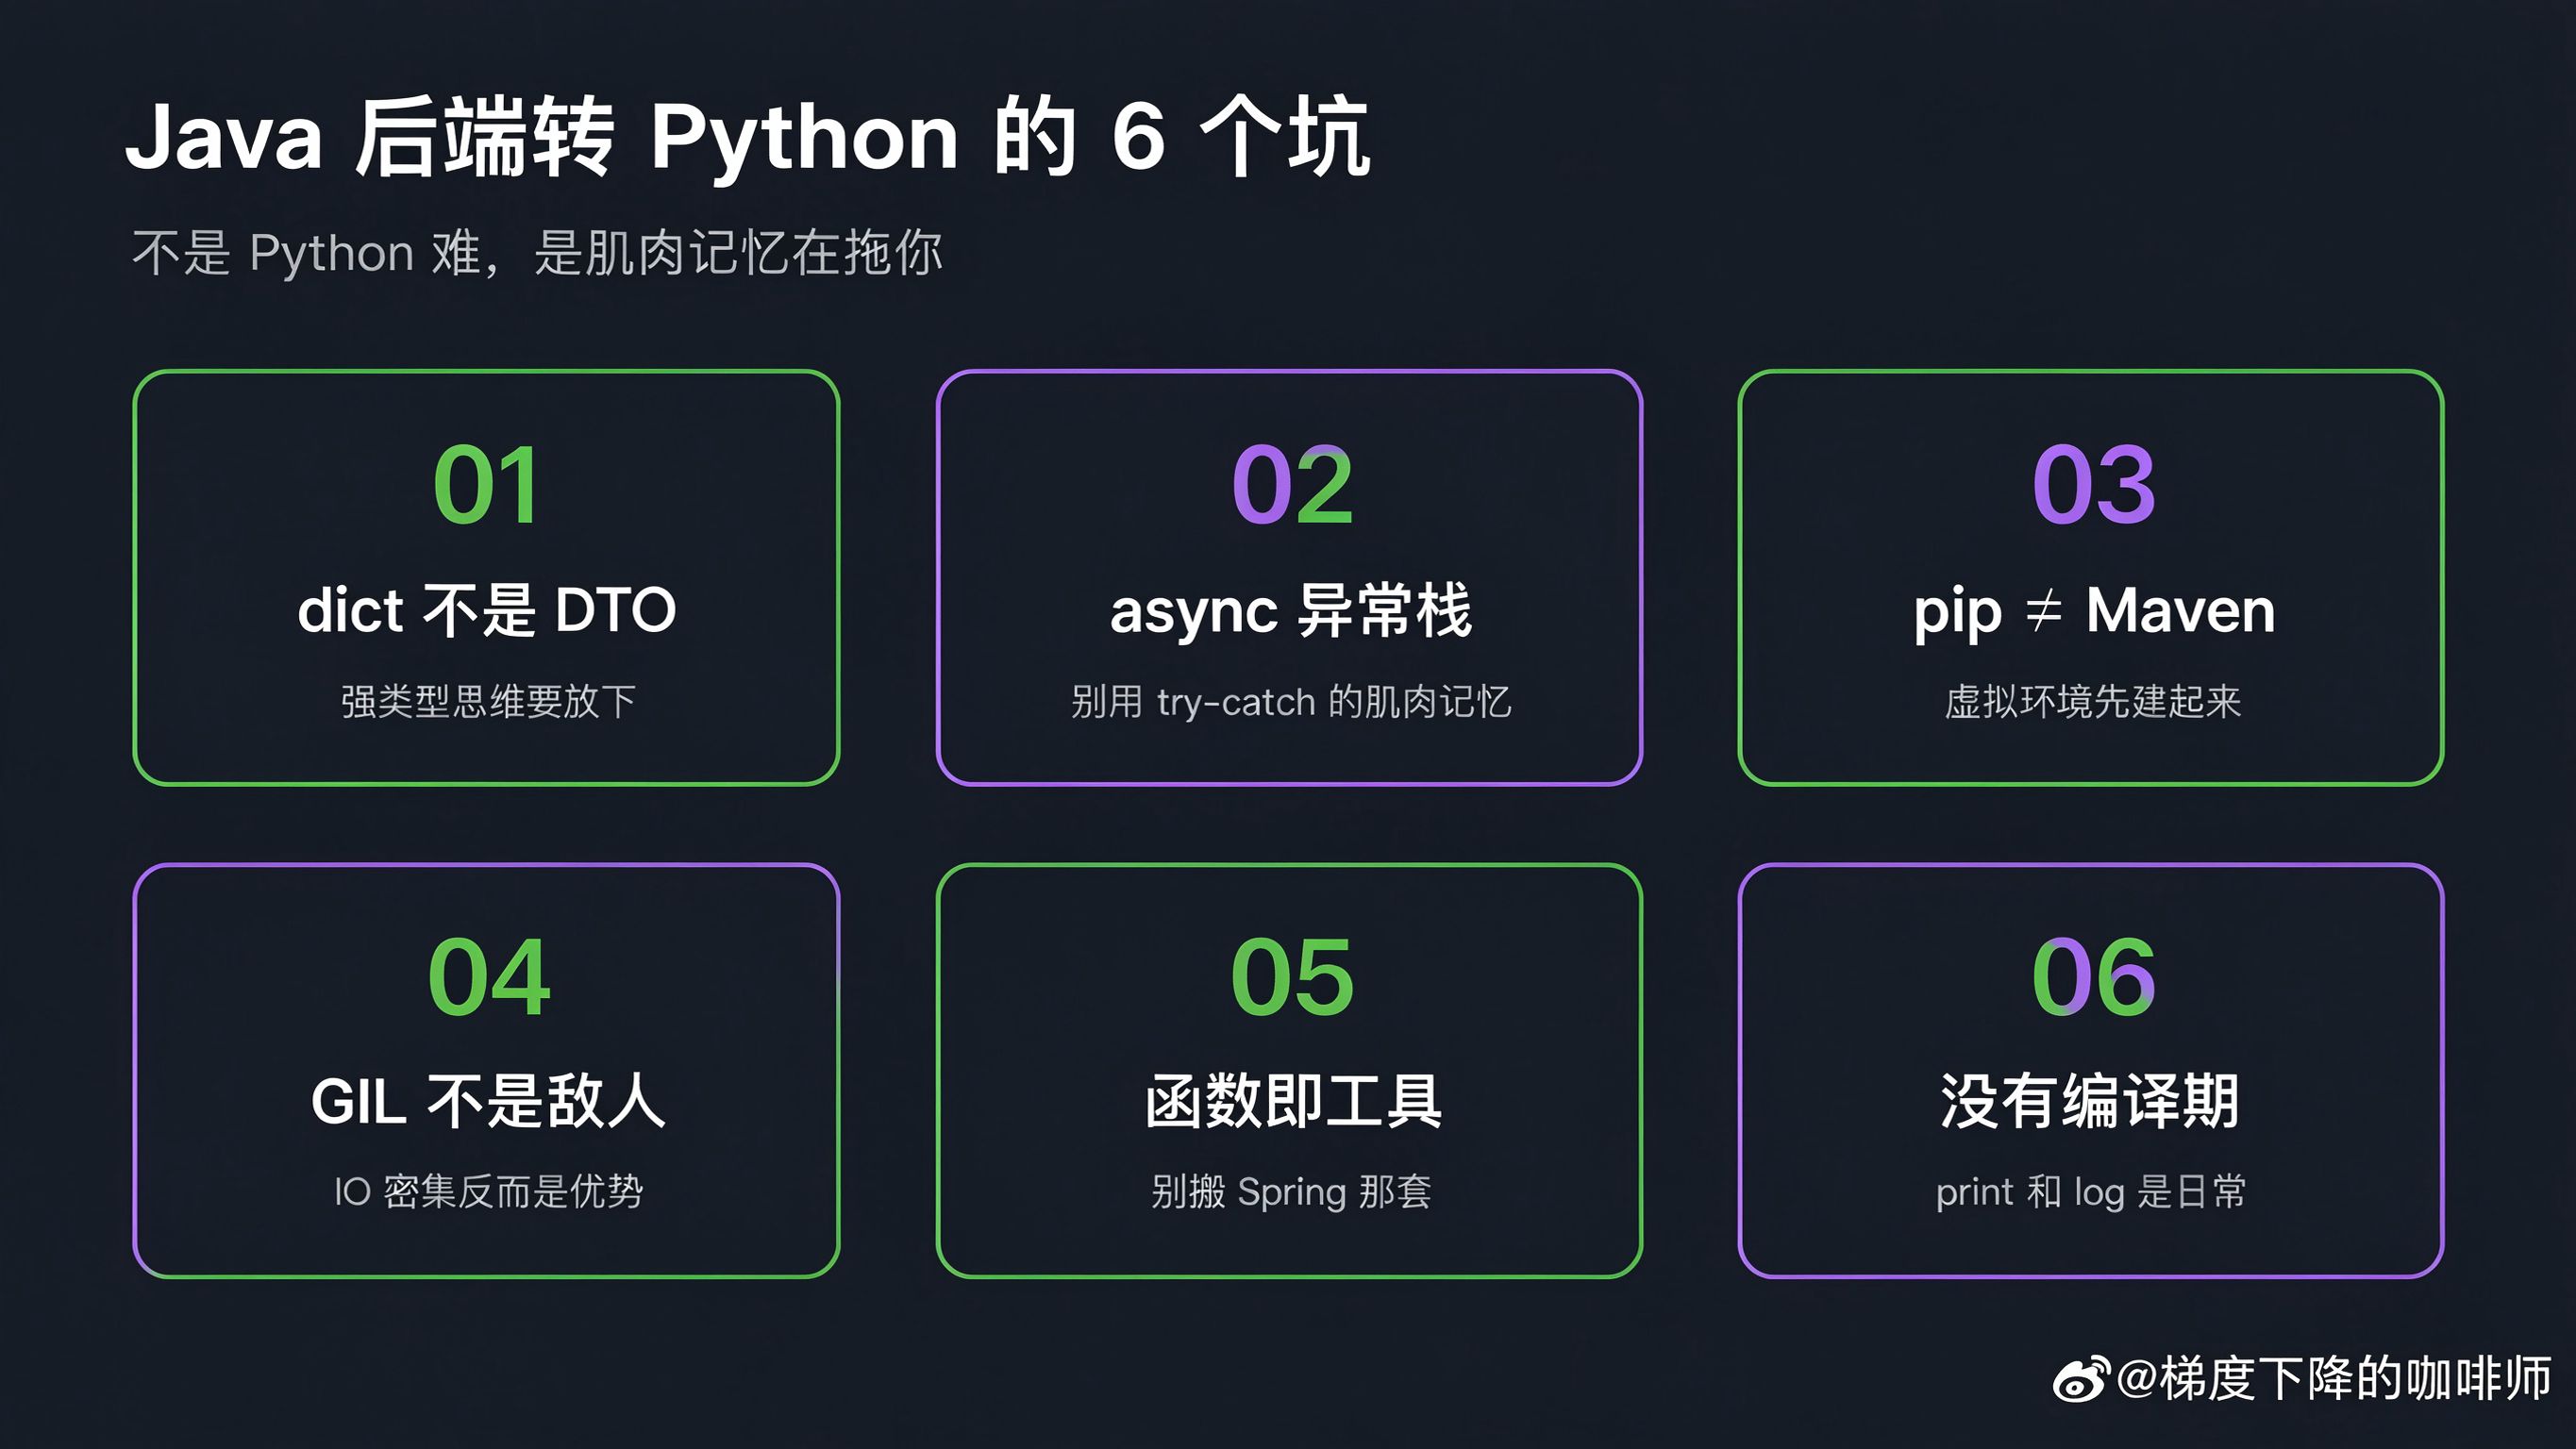
图:六个坑一览
坑 1|强类型思维:dict 不是 DTO
刚上来你会手痒:写个 WeatherResult class,字段 city、temperature、unit 配上,再来个 @Data。然后你会发现,SDK 返回的对象虽然能用点号访问,但最关键的那堆工具参数藏在 function.arguments 里——它是个 JSON 字符串,你得自己 json.loads() 解开,key 是什么还得对着文档猜。
Java 里 DTO 是契约,编译期就锁住了。Python 里 SDK 给你的就是个 dict——OpenAI 升级一次字段名,你的代码可能默默地拿到 None。
怎么办:要么用 pydantic.BaseModel 定义 schema,配合结构化输出让模型直接吐校验过的 JSON;要么老老实实 .get(),在边界处做校验。别再写传统 Java DTO 了——pydantic 不是你熟悉的那种 DTO,它是个运行时校验器。
日常调试时模型吐回来的 arguments 就是一坨 JSON 字符串,我一般直接粘到 forjson.com 一键格式化——省得在终端里数括号,还能顺便校验字段对不对。写 Agent 之后这种事天天干,我干脆自己做了这个在线工具箱。
坑 2|async 里的异常栈是乱的
Java 的 try-catch 你闭着眼都能写。到了 Python 的 asyncio,你会发现:协程里抛了异常,异常栈居然不指向你 throw 的那行,而是指向 event loop 调度的那行。
更坑的是:你在 main 里 await 一个 task,task 内部又起了个嵌套 task——异常被吞了,程序不报错,就是结果不对。线上排查的时候你会想死。
我有一次线上排查,一个异步任务里面嵌套了三层 await,最里面那个网络请求超时抛了异常,结果外层啥也没捕获,程序就"静默失败"了——不报错、不退出、就是不出结果。我对着日志看了两个小时,最后发现异常栈指向的是 event loop 的启动行,跟我代码里任何一行都对不上。
经验:所有 task 都要被 await 或 asyncio.gather,别 fire-and-forget;用 asyncio.run(),别自己折腾 loop;日志里打异常一定要带 traceback,别只打 str(e)。
坑 3|pip ≠ Maven:虚拟环境先建起来
Maven 一个 pom.xml 搞定,依赖树干净,版本锁得死死的。pip 呢?你 pip install openai,顺手装了一堆 transitive dependencies;过两天在另一台机器上 pip install -r requirements.txt,装出来的版本对不上,报一堆莫名其妙的错。
最大的坑:系统 Python 和项目 Python 混在一起。你全局装了 openai 1.x,另一个项目要 0.28,直接打架。
别偷懒:上来先 python -m venv .venv && source .venv/bin/activate。锁版本用 pip freeze > requirements.txt,追求可复现就上 uv 或 poetry。AI 生态 SDK 版本迭代极快,0.28 和 1.x 的 API 完全不一样,这一步比你想象的重要。
坑 4|GIL 不是敌人,IO 密集反而是优势
Java 后端聊并发,第一反应是多线程、线程池。到了 Python 听说有 GIL,同一时刻只有一个线程跑字节码,第一反应:那性能不就拉胯了?
但写 AI 应用你会发现:绝大多数时间你在等——等模型 API 返回,等数据库,等 HTTP 请求。这是 IO 密集,不是 CPU 密集。GIL 在 IO 等待时会释放,asyncio + 协程反而比 Java 线程池更轻量。
真要 CPU 密集(本地跑模型、大规模 tokenize),那就上 multiprocessing,或者干脆交给 C 扩展(numpy、torch 会释放 GIL)。别用 Java 的并发模型硬套 Python。
简单对比一下 Java 线程和 Python 协程在 IO 等待时的表现:
- Java Tomcat 线程:一个请求占一个线程,查数据库时线程阻塞在那;并发数靠堆线程,每个线程约 1MB 栈内存
- Python asyncio 协程:单线程事件循环,查数据库时把控制权让出去处理别的请求,IO 回来再继续;并发数靠协程,一个协程几 KB
看到区别没?写 AI 应用,你大部分时间在等,所以 Python 的 async 反而顺手。
坑 5|函数即工具:别搬 Spring 那套
在 Spring 里加个工具,你得:写接口、写实现类、加 @Service、配 @Autowired、在配置类里注册 Bean。
到了 Python 的 Function Calling,一个普通函数 + 几行 schema 描述就是一个工具。原生 SDK 就是手写 JSON Schema(下面代码你会看到);像 LangChain 这样的框架甚至封装了 @tool 装饰器,自动从函数签名和 docstring 生成 Schema。
你不需要 Service 层,不需要 Bean 容器,不需要接口实现分离。Agent 场景下工具是快速试错的,不是设计一次就不动的——想复杂了反而拖慢迭代。
坑 6|没有编译期检查:print 和 log 是日常
Java 里你改个字段名,IDE 立刻红线,编译都过不了。Python 呢?你改个变量名,代码能跑,跑到那行才 NameError。
这在 AI 应用里尤其要命:我有一次写一个工具函数,参数名是 user_id,结果模型那边传过来的是 userId(驼峰),我的函数收到 None,然后默默返回了一个空列表。模型拿到空列表,又编了一段"暂无用户数据"的回答——用户看到的就是一个假答案,还特别像真的。这种 bug 不 crash、不报警,是最危险的。
习惯:写 Python 写 AI,print 和 logging 不是调试手段,是日常基建。每个工具函数进来打一行参数、出去打一行结果;异常一定打全 traceback。等后面上 LangSmith、Langfuse,这些就是 trace 的骨架。
04 一段代码,跑通 Function Calling
光说不练假把式。下面这段代码,pip install openai 之后,把 OPENAI_API_KEY 换成你自己的,就能跑。它做的事:定义一个查天气的工具,让模型自己决定要不要调,调完把结果填回去再回答用户。
| |
跑起来你会看到:模型先吐出两个 tool_call(北京、深圳各一次),你的代码拿到参数、调函数、把结果填回去,模型最后给你一段自然语言总结。
注意代码里那行 print——这就是坑 6 的缩影。真实项目里这行是 logging,但思路一样:你必须知道模型让你调了什么、你返回了什么,不然出问题就是黑盒。
还有一件事值得说清楚:messages 这个列表里混着四种角色,别搞混。
- system:给模型定人设和规则的,一般只在开头放一条,比如你是一个严谨的助手
- user:你说的话
- assistant:模型说的话,包括它要求调工具的那段(带
tool_calls字段) - tool:你执行完工具之后塞回去的结果——
tool_call_id就是把这条结果和上面 assistant 的请求对上号的,对不上模型会报错
这四个角色缺一不可。你后面写 Agent 会天天跟这个列表打交道,先混个脸熟。
05 写在最后
写到这里你应该发现了:这六个坑,没有一个是 Python 本身难。
dict 不是因为 Python 弱,是因为大模型返回的本来就是 JSON;async 异常栈不是 bug,是协程模型和线程模型本来就不一样;GIL 在 IO 场景下根本不是瓶颈;函数即工具,是因为 AI 应用迭代快,不需要 Spring 那套重量级抽象。
不是 Python 难,是 Java 的肌肉记忆在拖你。
写了十年 Java,我刚转的时候也天天别扭。但别扭一个月之后你会发现:Python 让你把精力放在"让模型干什么"上,而不是"怎么把这个 DTO 注册进容器"上。对 AI 应用来说,这才是对的重心。
旧炉未冷,新火已燃。我们下篇见。
关注公众号「梯度下降的咖啡师」,或访问 gradcoffee.com。下一篇我们把这段单轮代码外面套一个 while,让模型自己决定调几轮工具——你的第一个 Agent 就出来了。
聊聊两个问题:
① 你从 Java(或其他强类型语言)转 Python,踩过最离谱的坑是什么?评论区给我开开眼。
② 下一篇我们写第一个 Agent——你觉得它最该先学会什么?是工具调用、长期记忆,还是自己反思纠错?
咖啡续命,梯度下降。| 作者:梯度下降的咖啡师